Inteligencia Artificial (IA)
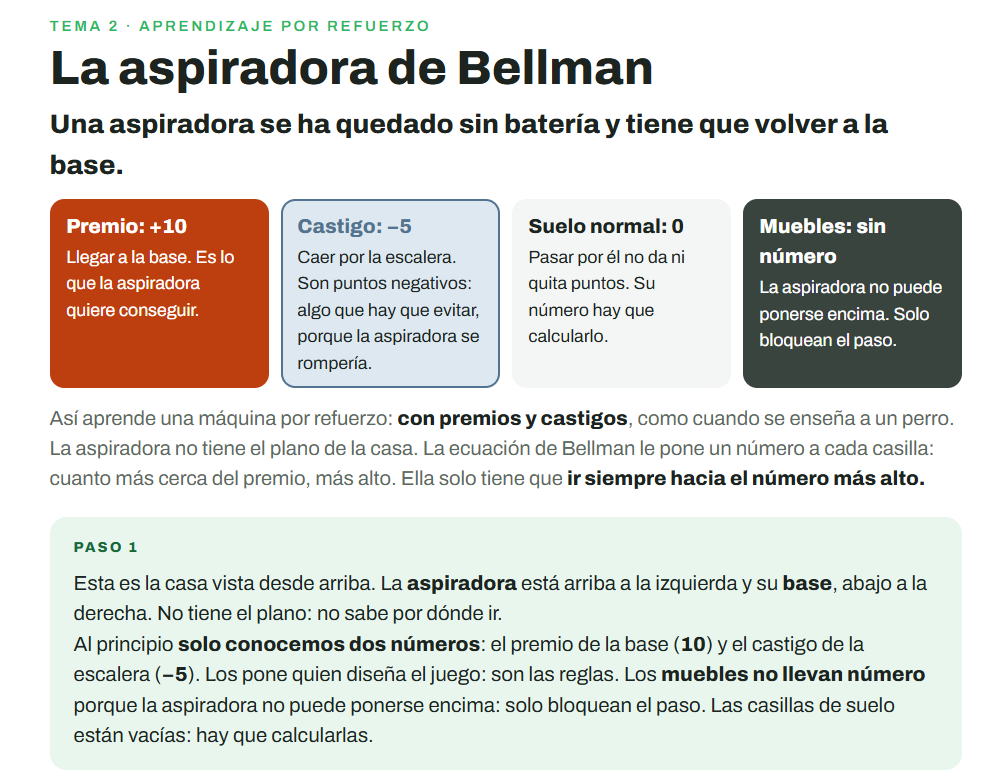
¿Cómo aprende una máquina a base de premios y castigos? Para mis alumnos del Máster en Inteligencia Institucional de la UNIA he preparado una web para explicar el aprendizaje por refuerzo, la técnica que hay detrás de AlphaGo, de la conducción autónoma o del ajuste final de ChatGPT. El ejemplo es doméstico: una aspiradora se queda sin batería y tiene que volver sola a su base. No tiene el plano de la casa. Solo sabe que llegar a la base es un premio (+10) y caer por la escalera, un castigo (−5). Con la ecuación de Bellman, cada casilla de la casa recibe un número: vale el 90 % de su mejor vecina. Es como el juego de frío o caliente. La aspiradora no necesita más: va siempre hacia el número más alto y llega sin que nadie le diga el camino. En la página se puede: Ver cómo se rellena cada casilla, paso a paso, con su cuenta. Mover la base o la aspiradora y ver cómo encuentra el nuevo camino. Resolver seis retos, entre ellos qué cambia si la máquina es más paciente o más impaciente. La misma lógica, a otra escala, decide cuándo una máquina sacrifica un premio inmediato por uno mayor. Entenderla ayuda a hacer mejores preguntas sobre la IA que usamos en las instituciones.